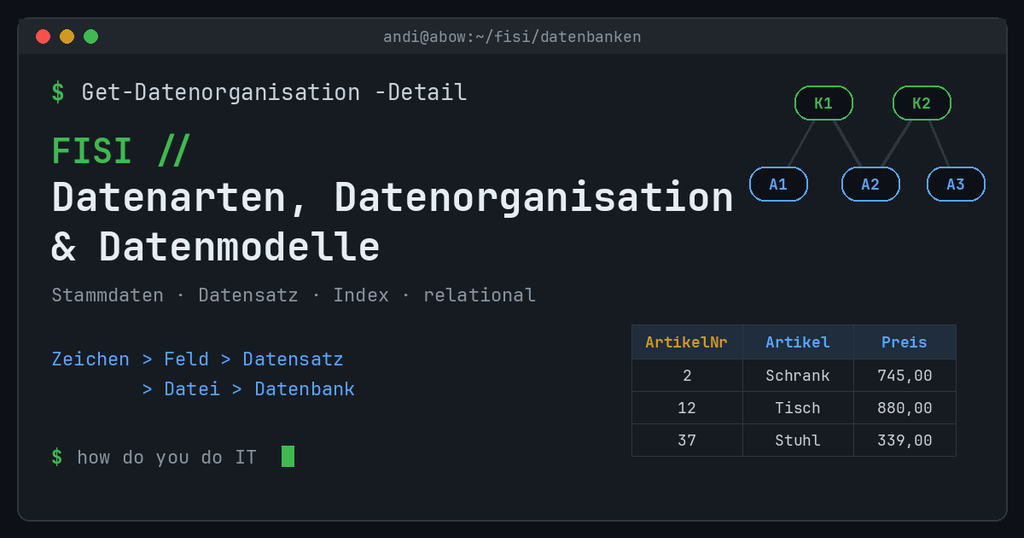
Bevor du in Access die erste Tabelle anlegst oder in SQL einen JOIN schreibst, fragt die Berufsschule erst mal die Grundbegriffe ab: Was sind Stammdaten, was ist ein Datensatz, wie unterscheidet sich sequentiell von index-sequentiell, und warum hat sich das relationale Modell durchgesetzt? Genau diese Begriffe tauchen in der FISI-Prüfung gern als Zuordnungsaufgabe auf.
In diesem Beitrag gehen wir das Thema einmal sauber durch, korrigieren ein paar Fehler, die in vielen Unterrichtsunterlagen stecken, und schauen uns mit PowerShell an, warum ein Index so viel schneller ist als stures Durchlesen.
Ziel
Nach dem Artikel kannst du
- Daten nach vier Merkmalen einordnen (Zeichenart, Änderungshäufigkeit, Aufgabe, Stellung im Prozess),
- die logische Hierarchie von Zeichen bis Datenbank erklären,
- sequentielle und index-sequentielle Speicherung unterscheiden,
- hierarchisches, Netzwerk- und relationales Datenmodell auseinanderhalten und Primär- und Fremdschlüssel richtig benennen.
Daten, Information, Wissen
Das klassische Unterrichtsbeispiel ist die Ampel. „Grün“ allein ist ein Datum, ein Zeichen ohne Zusammenhang. Erst im Kontext („Ich stehe mit dem Auto an dieser Ampel“) wird daraus eine Information. Wissen ist, was du daraus machst: Du weißt, dass du losfahren darfst, aber trotzdem auf Fußgänger achten musst.
Eine Datenbank speichert Daten. Informationen entstehen erst, wenn jemand sie abfragt und einordnet.
Datenarten
Daten lassen sich nach vier Merkmalen unterscheiden. Ein und dasselbe Datum kann dabei in mehreren Kategorien gleichzeitig stecken: Eine Artikelnummer ist numerisch, Stammdatum, Ordnungsdatum und Eingabedatum.
| Merkmal | Datenart | Beschreibung | Beispiele |
|---|---|---|---|
| Art der Zeichen | alphabetisch | nur Buchstaben | Josef Kranz |
| numerisch | nur Ziffern | 389, 4711 | |
| alphanumerisch | beliebige Zeichen | 48653 Coesfeld, 45 % Luftfeuchte | |
| Häufigkeit der Veränderung | Stammdaten | bleiben lange gleich, werden immer wieder verwendet | Artikelbezeichnung, Stückpreis, Lagernummer, Kundenanschrift |
| Bewegungsdaten | entstehen im Tagesgeschäft ständig neu | Belegdatum, Rechnungsbetrag, Fälligkeit, Bestellmenge | |
| Aufgabe im Verarbeitungsprozess | Rechendaten | mit ihnen wird gerechnet | Rabatt in %, Einzelpreis, Menge |
| Ordnungsdaten | identifizieren und sortieren | Kundenname, Artikelnummer, Postleitzahl | |
| Stellung im Verarbeitungsprozess | Eingabedaten | gehen in die Verarbeitung hinein | Menge und Einzelpreis, Radius und π |
| Ausgabedaten | Ergebnis der Verarbeitung | Gesamtpreis, Kreisfläche |
Manche Lehrbücher ergänzen bei der Änderungshäufigkeit noch Bestandsdaten (z. B. Lagerbestand, Kontostand) und Änderungsdaten (Daten, die Stammdaten ändern, etwa eine neue Anschrift). Wenn dein Lehrer die nicht erwähnt, reichen Stamm- und Bewegungsdaten.
Die Faustregel für Rechen- gegen Ordnungsdaten: Würde es Sinn ergeben, damit zu rechnen? Zwei Postleitzahlen zu addieren ergibt keinen Sinn, also ist die PLZ ein Ordnungsdatum, auch wenn sie nur aus Ziffern besteht.
Logische Datenorganisation
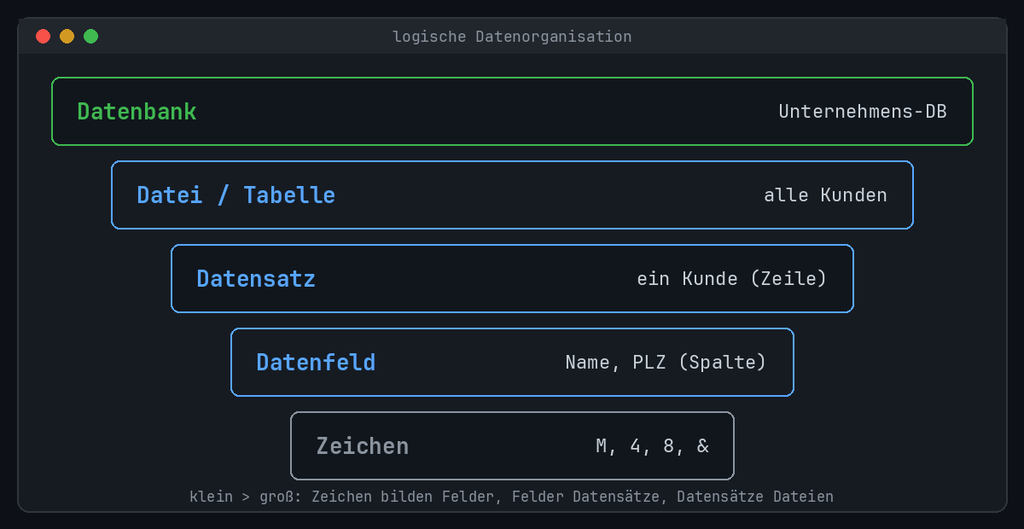
Die logische Sicht beschreibt, wie Daten aus Anwendersicht aufgebaut sind, unabhängig davon, wo sie physisch auf dem Datenträger liegen.
| Begriff | Beschreibung | Vergleich Excel | Beispiel |
|---|---|---|---|
| Zeichen / Datenelement | kleinste logische Einheit (Ziffer, Buchstabe, Sonderzeichen) | ein Zeichen in einer Zelle | 1, A, & |
| Datenfeld | hat einen Namen, einen Datentyp und eine Feldlänge und enthält genau eine Information | Zelle bzw. Spalte | Name, Straße |
| Datensatz | alle zusammengehörenden Datenfelder eines Objekts | Zeile | ein Mitarbeiter |
| Datei | alle zusammengehörenden Datensätze | Tabellenblatt | alle Mitarbeiter |
| Datenbank | größte logische Einheit, besteht aus mehreren Dateien | Arbeitsmappe | Unternehmens-DB |
Im relationalen Umfeld sagt man statt „Datei“ heute meist Tabelle (formal: Relation), statt „Datensatz“ Tupel und statt „Datenfeld“ Attribut. In der Prüfung werden beide Begriffswelten verwendet.
Physische Datenorganisation
Die physische Sicht beschreibt, wie Datensätze tatsächlich auf dem Speichermedium abgelegt und wiedergefunden werden.
Sequentielle Organisation
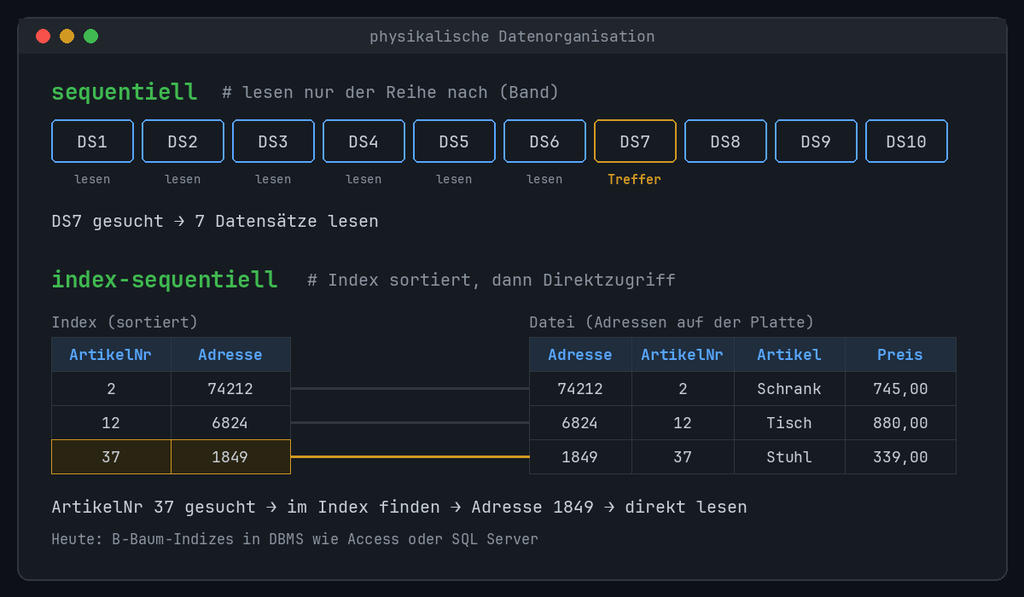
Die Datensätze liegen lückenlos hintereinander und können nur in dieser Reihenfolge gelesen werden. Um an DS7 zu kommen, liest du DS1 bis DS6 mit. Das typische Medium ist das Magnetband. Bänder sind übrigens nicht ausgestorben: LTO-Bänder sind im Backup-Bereich weiterhin verbreitet, gerade weil Backups ohnehin am Stück geschrieben und gelesen werden.
Bei n Datensätzen brauchst du im Schnitt n/2 Lesevorgänge, im schlechtesten Fall n.
Index-sequentielle Organisation
Zusätzlich zu den Daten gibt es eine Indextabelle, die nach dem Schlüssel sortiert ist und zu jedem Schlüssel die Adresse des Datensatzes speichert. Gesucht wird zuerst im kleinen Index, danach wird der Datensatz direkt über seine Adresse gelesen. Das setzt ein Medium mit Direktzugriff voraus, also eine Festplatte oder SSD.
Beim klassischen Verfahren (ISAM, Index Sequential Access Method) liegen die Datensätze zusätzlich nach dem Schlüssel sortiert in Blöcken. Daher der Name: Du kannst die Datei sequentiell in Schlüsselreihenfolge durchlesen oder über den Index gezielt springen.
Weil der Index sortiert ist, muss er nicht von vorne durchlaufen werden. Mit einer Binärsuche halbierst du den Suchbereich bei jedem Schritt und brauchst bei 1.000.000 Einträgen höchstens 20 Vergleiche. Moderne Datenbanksysteme wie Access oder SQL Server verwalten Indizes als B-Bäume, das Prinzip ist aber dasselbe.
Datenmodelle
Ein Datenmodell beschreibt formal, welche Objekte (Entitäten) es gibt, welche Eigenschaften (Attribute) sie haben und wie sie zueinander in Beziehung stehen. Beispiel: Die Objekte sind Kunde und Auftrag, die Attribute Kundenname und Auftragsnummer, und die Beziehung lautet „Die Meier OHG bestellt 24 Bürostühle“.
Hierarchisches Datenmodell
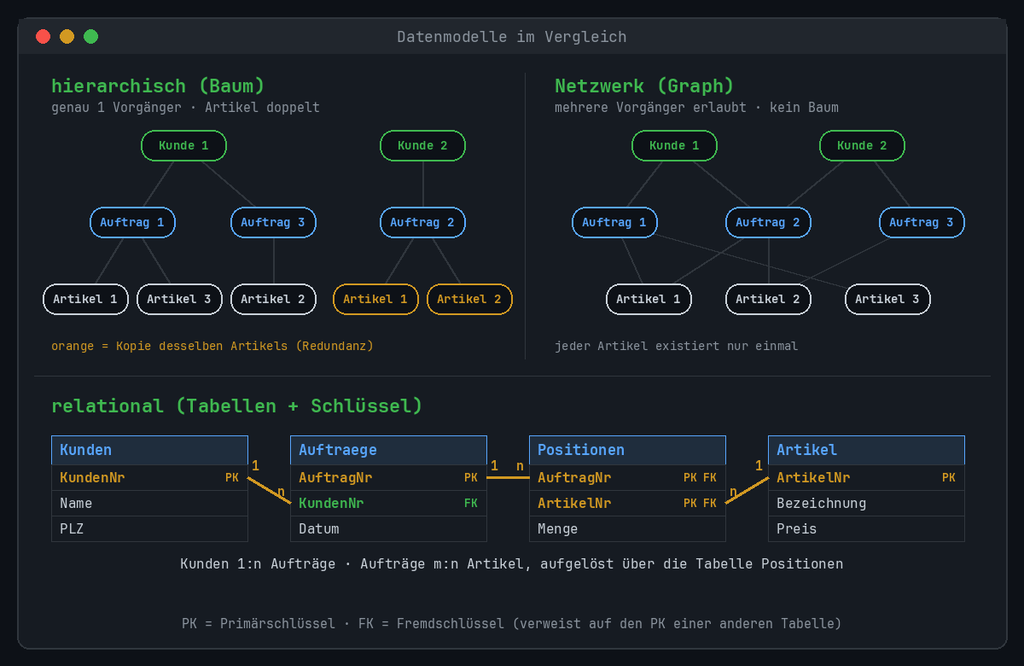
Die Daten sind als Baum organisiert. Jeder Knoten hat genau einen Vorgänger, nur die Wurzel hat keinen. Das passt gut zu 1:n-Beziehungen (ein Kunde, mehrere Aufträge), scheitert aber an m:n-Beziehungen: Wenn Artikel 1 in Aufträgen von zwei verschiedenen Kunden vorkommt, muss er im Baum doppelt gespeichert werden. Das führt zu Redundanz und damit zu Inkonsistenzen, sobald eine Kopie geändert wird und die andere nicht. Bekanntester Vertreter ist IBMs IMS aus den 1960er-Jahren. Die Idee lebt in XML- und JSON-Dokumenten und in LDAP-Verzeichnissen weiter, das Active Directory ist ebenfalls baumförmig aufgebaut.
Netzwerkdatenmodell
Hier darf ein Knoten mehrere Vorgänger haben. Damit ist die Struktur kein Baum mehr, sondern ein Netz (Graph). Artikel 1 existiert nur einmal und kann trotzdem mehreren Aufträgen zugeordnet werden. Der Nachteil: Die Zugriffspfade sind fest im Schema verdrahtet, Abfragen müssen sich durch die Verbindungen hangeln, und Änderungen an der Struktur sind aufwendig. Standardisiert wurde das Modell von der CODASYL-Gruppe.
Relationales Datenmodell
Alle Daten liegen in Tabellen: Spalten sind die Attribute, Zeilen die Datensätze. Jede Tabelle hat einen Primärschlüssel (PK), der jeden Datensatz eindeutig identifiziert. Beziehungen entstehen, indem eine Tabelle den Primärschlüssel einer anderen als Fremdschlüssel (FK) speichert. Die Grundlage hat Edgar F. Codd 1970 veröffentlicht. Access, SQL Server, MySQL, PostgreSQL und Oracle arbeiten alle relational.
m:n-Beziehungen werden über eine Zwischentabelle aufgelöst. Aufträge und Artikel hängen also nicht direkt zusammen, sondern über die Tabelle Positionen, die sich Auftragsnummer, Artikelnummer und Menge merkt.
So sieht das Modell aus der Grafik in Standard-SQL aus:
CREATE TABLE Kunden (
    KundenNr   INTEGER      PRIMARY KEY,
    Name       VARCHAR(100) NOT NULL,
    PLZ        CHAR(5)
);

CREATE TABLE Auftraege (
    AuftragNr  INTEGER      PRIMARY KEY,
    KundenNr   INTEGER      NOT NULL REFERENCES Kunden(KundenNr),
    Datum      DATE
);

CREATE TABLE Artikel (
    ArtikelNr    INTEGER       PRIMARY KEY,
    Bezeichnung  VARCHAR(100)  NOT NULL,
    Preis        DECIMAL(10,2)
);

CREATE TABLE Positionen (
    AuftragNr  INTEGER NOT NULL REFERENCES Auftraege(AuftragNr),
    ArtikelNr  INTEGER NOT NULL REFERENCES Artikel(ArtikelNr),
    Menge      INTEGER NOT NULL,
    PRIMARY KEY (AuftragNr, ArtikelNr)
);
Der Primärschlüssel von Positionen ist zusammengesetzt aus beiden Fremdschlüsseln. Damit kann derselbe Artikel pro Auftrag nur einmal auftauchen, die Stückzahl steht in Menge.
Praxis: Sequentiell gegen Index in PowerShell
Wie groß der Unterschied zwischen den beiden Zugriffsarten ist, lässt sich gut nachmessen. Das Skript legt eine „Datei“ mit Artikeln in zufälliger Reihenfolge im Arbeitsspeicher an, sucht einen Artikel einmal sequentiell und einmal über einen sortierten Index mit Binärsuche. Am System wird nichts verändert.
<#
.SYNOPSIS
    Vergleicht sequentielle Suche mit Zugriff über einen sortierten Index.

.DESCRIPTION
    Erzeugt eine "Datei" mit Test-Artikeln (Datensätzen) in zufälliger Reihenfolge.
    Danach wird ein Artikel auf zwei Wegen gesucht:
      1. Sequentiell: Datensatz für Datensatz von vorne durchgehen (wie beim Magnetband)
      2. Über einen Index: sortierte Tabelle ArtikelNr -> Adresse, Binärsuche im Index,
         danach Direktzugriff auf die Adresse (Prinzip der index-sequentiellen Organisation)
    Das Skript ändert nichts am System, es arbeitet nur im Arbeitsspeicher.

.PARAMETER Anzahl
    Anzahl der zu erzeugenden Datensätze (1.000 bis 2.000.000). Standard: 100.000

.PARAMETER Suchnummer
    Gesuchte Artikelnummer. Ohne Angabe wird eine zufällige gültige Nummer gewählt.

.EXAMPLE
    .\PS_Datenorganisation_Vergleich.ps1

.EXAMPLE
    .\PS_Datenorganisation_Vergleich.ps1 -Anzahl 500000 -Suchnummer 4711

.NOTES
    Name: PS_Datenorganisation_Vergleich
    Author: Andreas Bowitz
    Version: 0.1
    LastUpdated: 2026-Sep-28
    Getestet mit PowerShell 7.4 (nutzt nur .NET-Funktionen, die auch unter Windows PowerShell 5.1 vorhanden sind)
#>
[CmdletBinding()]
param(
    [ValidateRange(1000, 2000000)]
    [int]$Anzahl = 100000,

    [int]$Suchnummer = 0
)

$rnd = [System.Random]::new()

if ($Suchnummer -lt 1 -or $Suchnummer -gt $Anzahl) {
    $Suchnummer = $rnd.Next(1, $Anzahl + 1)
}

# --- 1. "Datei" anlegen: Datensätze in zufälliger Reihenfolge -------------------
Write-Host "Erzeuge $Anzahl Datensaetze ..." -ForegroundColor Cyan

$nummern = [int[]](1..$Anzahl)
# Fisher-Yates-Shuffle, damit die Datensätze unsortiert abgelegt werden
for ($i = $nummern.Length - 1; $i -gt 0; $i--) {
    $j = $rnd.Next(0, $i + 1)
    $tmp = $nummern[$i]; $nummern[$i] = $nummern[$j]; $nummern[$j] = $tmp
}

$datei = [System.Collections.Generic.List[object]]::new($Anzahl)
for ($adresse = 0; $adresse -lt $Anzahl; $adresse++) {
    $nr = $nummern[$adresse]
    $datei.Add([pscustomobject]@{
        Adresse   = $adresse
        ArtikelNr = $nr
        Artikel   = "Artikel $nr"
        Preis     = [math]::Round($rnd.Next(100, 100000) / 100, 2)
    })
}

# --- 2. Sequentielle Suche ------------------------------------------------------
$sw = [System.Diagnostics.Stopwatch]::StartNew()
$vergleicheSeq = 0
$trefferSeq = $null
foreach ($ds in $datei) {
    $vergleicheSeq++
    if ($ds.ArtikelNr -eq $Suchnummer) { $trefferSeq = $ds; break }
}
$sw.Stop()
$zeitSeq = $sw.Elapsed.TotalMilliseconds

# --- 3. Index aufbauen: ArtikelNr -> Adresse, sortiert nach ArtikelNr ----------
$sw.Restart()
$idxSchluessel = [int[]]::new($Anzahl)
$idxAdresse    = [int[]]::new($Anzahl)
for ($k = 0; $k -lt $Anzahl; $k++) {
    $idxSchluessel[$k] = $datei[$k].ArtikelNr
    $idxAdresse[$k]    = $datei[$k].Adresse
}
[Array]::Sort($idxSchluessel, $idxAdresse)   # sortiert beide Arrays nach dem Schlüssel
$sw.Stop()
$zeitIndexAufbau = $sw.Elapsed.TotalMilliseconds

# --- 4. Suche über den Index ----------------------------------------------------
$sw.Restart()
$pos = [Array]::BinarySearch($idxSchluessel, $Suchnummer)
$trefferIdx = if ($pos -ge 0) { $datei[$idxAdresse[$pos]] } else { $null }
$sw.Stop()
$zeitIdx = $sw.Elapsed.TotalMilliseconds
$vergleicheIdx = [math]::Ceiling([math]::Log($Anzahl, 2))

# --- 5. Ergebnis ----------------------------------------------------------------
Write-Host "`nGesuchte ArtikelNr: $Suchnummer" -ForegroundColor Yellow
$trefferIdx | Format-Table Adresse, ArtikelNr, Artikel, Preis -AutoSize

[pscustomobject]@{ Verfahren = 'Sequentiell';          Vergleiche = $vergleicheSeq;        'Zeit (ms)' = [math]::Round($zeitSeq, 3) },
[pscustomobject]@{ Verfahren = 'Index (Binaersuche)';  Vergleiche = "max. $vergleicheIdx"; 'Zeit (ms)' = [math]::Round($zeitIdx, 3) },
[pscustomobject]@{ Verfahren = 'Index aufbauen (1x)';  Vergleiche = '-';                   'Zeit (ms)' = [math]::Round($zeitIndexAufbau, 3) } |
    Format-Table -AutoSize

if ($trefferSeq.Adresse -ne $trefferIdx.Adresse) {
    Write-Warning "Beide Verfahren liefern unterschiedliche Treffer - das darf nicht passieren."
}
Erklärung
| Abschnitt | Was passiert | Bezug zur Theorie |
|---|---|---|
$nummern + Shuffle | Artikelnummern 1 bis n werden mit dem Fisher-Yates-Verfahren gemischt | Datensätze liegen unsortiert auf dem „Datenträger“ |
$datei | Liste mit pscustomobject-Datensätzen, die Position in der Liste ist die Adresse | Datei aus Datensätzen mit den Feldern Adresse, ArtikelNr, Artikel, Preis |
foreach ... break | läuft von vorne durch, bis die Nummer gefunden ist, und zählt dabei mit | sequentieller Zugriff |
[Array]::Sort($a, $b) | sortiert die Schlüssel und zieht die Adressen parallel mit | Indextabelle ArtikelNr → Adresse, sortiert |
[Array]::BinarySearch() | Binärsuche im sortierten Index, liefert die Position im Index | schnelles Finden im Index |
$datei[$idxAdresse[$pos]] | Sprung direkt zur gespeicherten Adresse | Direktzugriff wie auf der Festplatte |
Stopwatch | misst die Zeiten der einzelnen Schritte | Vergleich der Verfahren |
Warum Stopwatch statt Measure-Command? Weil damit die Zählvariablen sicher im Skript-Scope bleiben und du Aufbau und Suche getrennt messen kannst.
Ergebnis
Ein Testlauf mit 100.000 Datensätzen und der Suchnummer 4711 unter PowerShell 7.4:
Gesuchte ArtikelNr: 4711

Adresse ArtikelNr Artikel       Preis
------- --------- -------       -----
  43897      4711 Artikel 4711 850.20

Verfahren           Vergleiche Zeit (ms)
---------           ---------- ---------
Sequentiell              43898     17.40
Index (Binaersuche)    max. 17      2.78
Index aufbauen (1x)          -     93.40
Die Adresse und damit die Zahl der sequentiellen Vergleiche ändert sich bei jedem Lauf, weil die Reihenfolge zufällig ist. Aussagekräftig ist vor allem die Spalte Vergleiche: knapp 44.000 gegen höchstens 17. Bei einer Million Datensätze waren es im Test rund 146.000 gegen höchstens 20. Die Millisekunden der Indexsuche bestehen fast nur aus dem Overhead des ersten .NET-Aufrufs, bei so kleinen Werten schwanken sie stark.
Die Zeile „Index aufbauen“ zeigt die Kehrseite: Der Index kostet einmalig Zeit und dauerhaft Speicher, und er muss bei jedem Einfügen, Ändern und Löschen mitgepflegt werden. Deshalb legt man Indizes auf Felder, nach denen oft gesucht wird, und nicht auf jede Spalte.
Stolperfallen
Netzwerkmodell ist kein Baum. In vielen Unterlagen steht, das Netzwerkmodell stelle die Beziehungen „ebenfalls in einer Baumstruktur“ dar. Das ist falsch. Sobald ein Knoten mehrere Vorgänger haben darf, ist es per Definition kein Baum mehr, sondern ein Graph.
Primär- und Fremdschlüssel, nicht Sekundärschlüssel. Beziehungen im relationalen Modell entstehen über Primärschlüssel und Fremdschlüssel (Foreign Key). Ein Sekundärschlüssel ist etwas anderes: ein Attribut, nach dem gesucht oder sortiert wird, ohne dass es eindeutig sein muss, etwa der Nachname. Darauf legt man einen Sekundärindex. Wer in der Prüfung „Sekundärschlüssel“ für die Verknüpfung schreibt, riskiert Punktabzug.
Der Index muss sortiert sein. Auf mancher Folie ist die Indextabelle unsortiert (37, 2, 12). Dann bringt der Index keinen Vorteil, weil du ihn wieder komplett durchsuchen müsstest. Außerdem wird ein sortierter Index nicht „sequentiell durchsucht“, sondern per Binärsuche oder Baumstruktur.
FAT ist kein index-sequentielles Beispiel. Die File Allocation Table (nicht „Allocataion“) wird gern als Beispiel genannt. Die FAT speichert aber pro Cluster den Verweis auf den nächsten Cluster einer Datei, das ist eine verkettete Zuordnung. Mit dem ISAM-Prinzip (sortierter Schlüsselindex auf sortierte Datenblöcke) hat das wenig zu tun.
Postleitzahl als Zahl speichern. Die PLZ besteht aus Ziffern, gehört aber in ein Textfeld. Als Zahl gespeichert wird aus 01067 (Dresden) plötzlich 1067. Gleiches gilt für Telefonnummern und Artikelnummern mit führenden Nullen. Faustregel: Wird nicht damit gerechnet, dann Text.
Datenbank ist nicht gleich DBMS. Die Datenbank ist der Datenbestand. Das Datenbankmanagementsystem (DBMS) ist die Software, die ihn verwaltet, zum Beispiel Access oder SQL Server. Beides zusammen nennt man Datenbanksystem (DBS). Die Folien-Definition „Datenbank = System zur Beschreibung, Speicherung und Wiedergewinnung“ beschreibt genau genommen das Datenbanksystem.
Eine Datenart schließt die anderen nicht aus. Die vier Merkmale sind unterschiedliche Blickwinkel. Die Menge in einer Bestellung ist gleichzeitig numerisch, Bewegungsdatum, Rechendatum und Eingabedatum.
Bonus: Zugriff auf mehrere Tabellen gleichzeitig
Der Vorteil des relationalen Modells aus der Theorie („auf die Daten in verschiedenen Tabellen gleichzeitig zugreifen“) sieht in SQL so aus:
SELECT k.Name, a.AuftragNr, ar.Bezeichnung, p.Menge,
       p.Menge * ar.Preis AS Gesamtpreis
FROM Kunden k
JOIN Auftraege  a  ON a.KundenNr   = k.KundenNr
JOIN Positionen p  ON p.AuftragNr  = a.AuftragNr
JOIN Artikel    ar ON ar.ArtikelNr = p.ArtikelNr
WHERE k.Name = 'Meier OHG';
Mit einem Auftrag über 24 Stühle zu 339,00 € und 2 Tische zu 880,00 € liefert die Abfrage 8.136,00 € und 1.760,00 € als Gesamtpreise, also Ausgabedaten aus Rechendaten. Die Fremdschlüssel sorgen außerdem dafür, dass kein Auftrag für einen Kunden angelegt werden kann, den es nicht gibt (referentielle Integrität).
In Access musst du das etwas anders schreiben: Access kennt kein nacktes JOIN, sondern nur INNER JOIN, und bei mehreren Verknüpfungen müssen die JOINs geklammert werden. Am einfachsten baust du die Abfrage in der Entwurfsansicht zusammen und schaust dir danach die SQL-Ansicht an.
Fazit
Datenarten sind Blickwinkel auf ein und dasselbe Datum, die logische Organisation reicht vom Zeichen bis zur Datenbank, und physisch entscheidet die Zugriffsart darüber, ob du dich durch alle Datensätze liest oder per Index direkt hinspringst. Bei den Datenmodellen hat sich das relationale Modell durchgesetzt, weil Tabellen mit Primär- und Fremdschlüsseln m:n-Beziehungen ohne Redundanz abbilden. Im nächsten Schritt geht es mit Normalisierung und ER-Modellen weiter (#).